
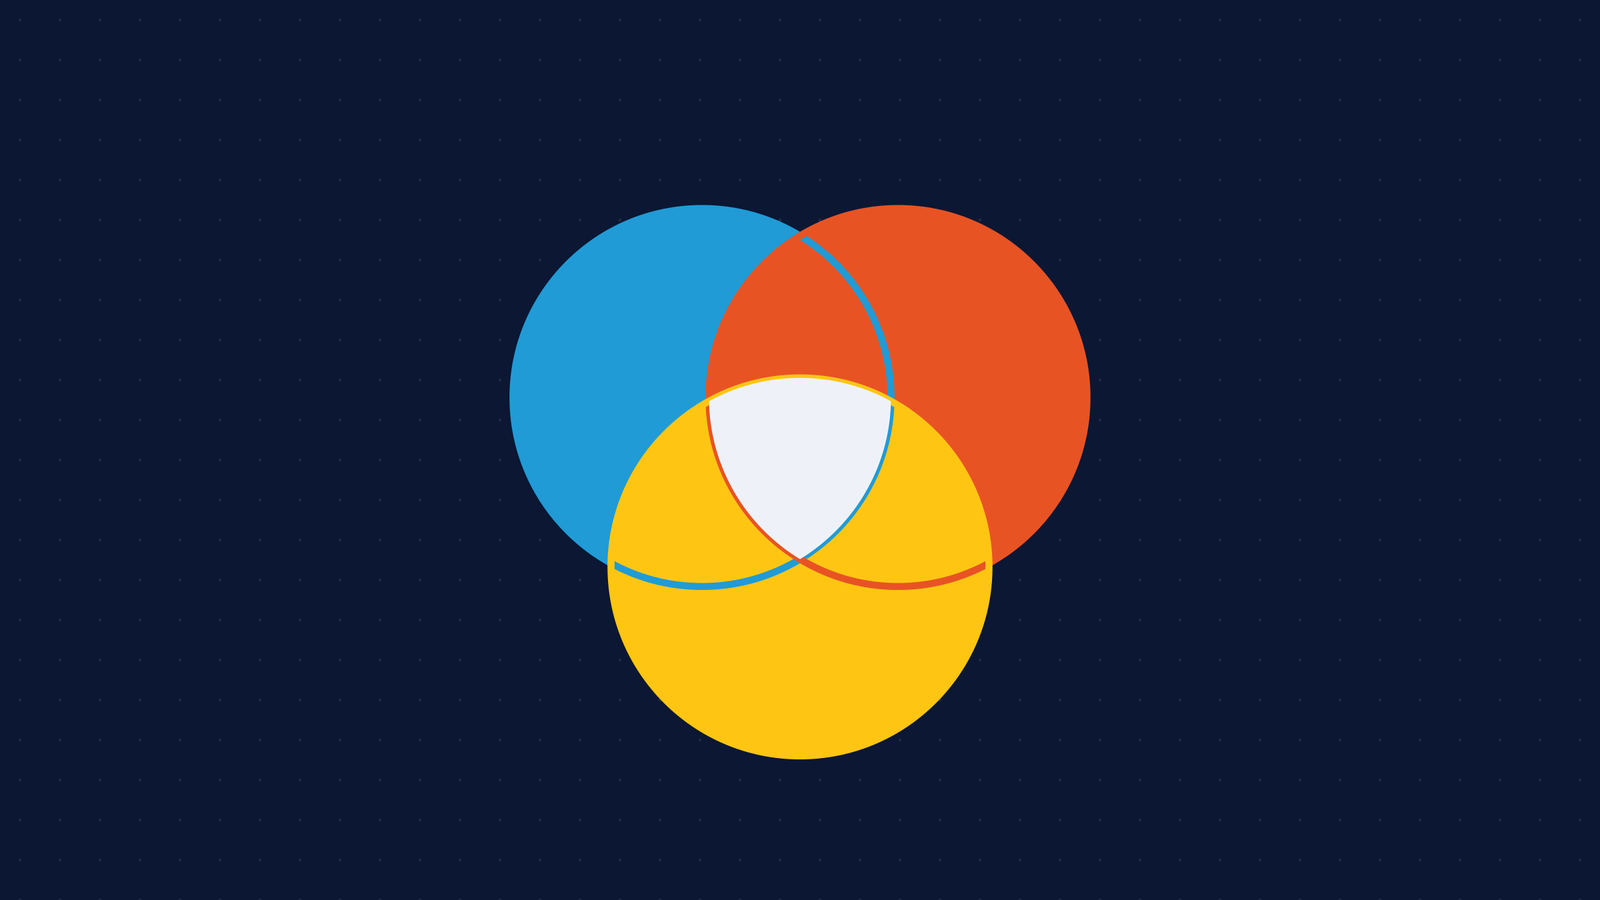
DevOps é a prática: quem desenvolve e quem opera dividem a responsabilidade de levar o software a produção e mantê-lo lá. SRE é um jeito concreto de fazer a parte da operação, com engenheiros de software, metas de confiabilidade e orçamento de erro. A engenharia de plataforma constrói o produto interno (caminhos pavimentados, portal, templates) para que cada time faça DevOps sem reinventá-lo. Uma empresa que cresce costuma precisar dos três, nessa ordem.
Faz mais de 18 anos que trabalho com isso e vi as três palavras virarem o título da mesma vaga. No currículo tanto faz. O problema aparece quando você precisa decidir o que contratar ou comprar, porque cada uma responde a uma pergunta diferente.
O que é DevOps, na prática?
Não é um time nem uma ferramenta. É o acordo de que quem constrói um serviço também cuida de como ele anda em produção, e de que o caminho do commit até a produção é automático, repetível e rápido. Pipelines de CI/CD, infraestrutura como código e monitoramento são a maquinaria que sustenta isso.
A prova mais clara de que funciona são as métricas de entrega de software da DORA: vazão (lead time das mudanças, frequência de deploy, tempo de recuperação) e instabilidade (taxa de falha das mudanças, taxa de retrabalho). O guia defende que velocidade e estabilidade não se opõem. Se você publica mais rápido, mas quebra mais, ainda não há DevOps. Como tirar esses números do seu pipeline está no texto sobre métricas DORA.
O que é SRE e no que difere de DevOps?
Site reliability engineering, a engenharia de confiabilidade, é a resposta do Google para a metade operacional. A definição do livro de SRE segue sendo a mais clara: o que acontece quando você pede a um engenheiro de software que desenhe um time de operações.
Dois mecanismos o separam de um time de operações tradicional. O primeiro é um teto para o trabalho operacional: o Google limita a 50% o trabalho de “ops” dos seus SREs (chamados, plantões, tarefas manuais). O resto vai para engenharia que elimina a necessidade desse trabalho, e se a operação passa do teto, o excedente volta para o time de desenvolvimento. O segundo é o orçamento de erro. O livro sustenta que 100% é a meta de confiabilidade errada para quase tudo: o negócio define uma meta de disponibilidade, e o orçamento de erro é um menos essa meta. Enquanto sobra orçamento, publica-se. Quando acaba, a confiabilidade vem primeiro.
SRE é, portanto, um jeito de fazer DevOps para operar produção, com opinião própria. Dá para fazer DevOps sem SRE. O contrário é muito difícil, porque o orçamento de erro só funciona se o desenvolvimento divide as consequências.
Num projeto nosso, isso vira o pacote Fundamentos de SRE e observabilidade: métricas, logs e traces conectados, 3 SLOs que descrevem o que o usuário sente, alertas testados até disparar e um runbook, por US$ 5.000 em 2 semanas. Um SLO é a meta de confiabilidade medida, como “99,9% das requisições respondem sem erro”. Não vendemos plantão 24x7: trabalhamos no horário comercial do cliente e deixamos alertas e runbooks para o plantão dele resolver os incidentes. Na plataforma da MPI, a produção passou de zero para 275 regras de alerta, cada uma testada até disparar.
O que é engenharia de plataforma?
É tratar a infraestrutura interna como um produto cujos usuários são os seus desenvolvedores. O white paper de plataformas da CNCF a define como um conjunto integrado de capacidades apresentado conforme o que os usuários precisam: uma camada transversal para o que muitas aplicações repetem.
Na prática são caminhos pavimentados. Templates que criam um serviço novo já ligado a CI/CD, observabilidade e deploy. Um portal, muitas vezes Backstage, com catálogo de serviços, documentação de APIs, responsáveis, estado dos deploys e autoatendimento num só lugar. Um jeito padrão de levar um release do desenvolvimento à produção, com verificações no caminho, e com varredura de segurança, visibilidade de custos e políticas embutidas ali, em vez de cada time adicionar as suas.
Ela existe por causa da escala. Com três times, cada um pode manter o seu pipeline. Com trinta, trinta pipelines parecidos mas diferentes viram o gargalo, e cada time gasta o tempo com encanamento em vez de produto.
Como os três se comparam lado a lado?
| Aspecto | DevOps | SRE | Engenharia de plataforma |
|---|---|---|---|
| Pergunta que responde | Como publicamos com frequência e sem medo? | Quão confiável isto precisa ser e quem conserta? | Como muitos times publicam sem refazer o encanamento? |
| Artefato principal | Pipelines, IaC | SLOs, alertas, runbooks, postmortems | Portal, templates, caminhos pavimentados |
| Mede-se por | Métricas DORA | SLOs e orçamento de erro | Adoção pelos desenvolvedores, mais DORA entre times |
| Usuários | O próprio time | O serviço e seus usuários | Os desenvolvedores internos |
Qual deles a minha empresa precisa primeiro?
Depende de onde dói.
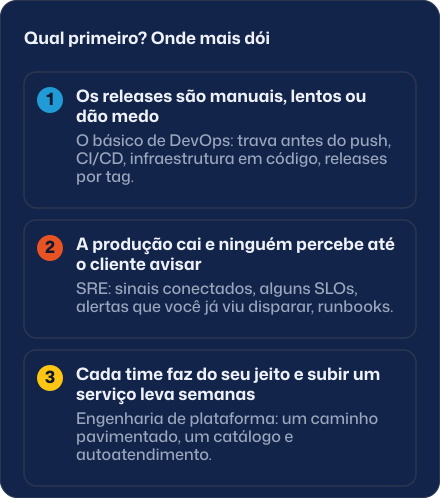
Se os releases são manuais, lentos ou dão medo, vem primeiro o básico de DevOps: uma trava antes do push, CI/CD, infraestrutura em código, releases por tag. Sem isso, nada do resto se sustenta. Se os releases andam, mas a produção cai e ninguém percebe até o cliente avisar, você precisa de SRE: sinais conectados, alguns SLOs que descrevam o que o usuário sente, alertas que você já viu disparar e runbooks. E se cada time faz tudo do seu jeito e subir um serviço novo leva semanas, precisa de engenharia de plataforma: um caminho pavimentado, um catálogo e autoatendimento.
Um erro frequente é comprar um portal antes de ter o básico de entrega (se a dúvida é construir ou comprar, há um texto à parte). Um catálogo Backstage que lista serviços com pipelines quebrados é só uma vista mais bonita do mesmo problema. Na The Platform Radar (em inglês) contei como começa toda avaliação que faço: o líder de engenharia me diz que o time tem Kubernetes, Terraform, um pipeline de CI/CD e alguma forma de monitoramento. Uma lista de ferramentas diz o que foi comprado. Não diz qual dos três trabalhos está sendo feito de verdade.
Preciso de um time diferente para cada um?
Antes de ter vários times de produto, quase nunca. Um engenheiro de plataforma que entenda os três consegue assentar a base se o trabalho tiver escopo. Na MPI, uma plataforma SaaS de análise de portfólios, o arranjo dos últimos 90 dias foi um engenheiro de plataforma da Clouditive, com um agente de IA de apoio, ao lado do responsável de DevOps do cliente e de cerca de oito engenheiros dele. Deu para construir o pipeline de promoção, o portal e os alertas porque os desenvolvedores continuaram donos dos seus serviços.
O resultado, medido nessa plataforma: os releases em produção passaram de 1,15 por semana (abril a julho de 2026) para entre 3,7 e 4,0 nos últimos 30 dias, e as falhas do pipeline de release em produção caíram de 23% (77 de 334, histórico) para 4% (1 de 25 desde julho de 2026).
O que não funciona é chamar alguém de “SRE” e entregar a essa pessoa só chamados. Sem o teto de trabalho operacional, o SRE volta a ser um time de operações tradicional com outro título.
SRE é o mesmo que DevOps? A engenharia de plataforma o substitui?
Nenhuma das duas. DevOps é a responsabilidade compartilhada e a prática de entrega. SRE é um jeito concreto de operar produção dentro dessa prática, e muito SRE faz trabalho de DevOps todo dia, por isso os títulos se misturam. A engenharia de plataforma empacota as práticas de DevOps para que mais times as usem sem construí-las. Se o time de plataforma deixa de ouvir os desenvolvedores e passa a impor, volta a ser o velho silo de operações, justamente o que o DevOps quis eliminar.
Por onde começar?
Escreva o que mais dói neste trimestre: a velocidade dos releases, os incidentes em produção ou a dispersão entre times. Escolha o primeiro passo correspondente e limite-o a duas semanas. Os pacotes que cobrem isso custam US$ 4.000 (CI/CD e IaC) e US$ 5.000 (Fundamentos de IDP, e Fundamentos de SRE e observabilidade), cada um por duas semanas.
Se a resposta é a dispersão e você está de olho num portal interno, a página de engenharia de plataforma explica o que os Fundamentos de IDP constroem e o caso que os sustenta. Para o lado de entrega, veja o serviço de DevOps, e para confiabilidade, o de SRE e observabilidade. Cada pacote tem seu preço em preços.
Fontes
- DORA, métricas de entrega de software, consultada em 7 de outubro de 2026.
- Livro de SRE do Google, introdução, consultado em 7 de outubro de 2026.
- White paper de plataformas da CNCF, consultado em 7 de outubro de 2026.