
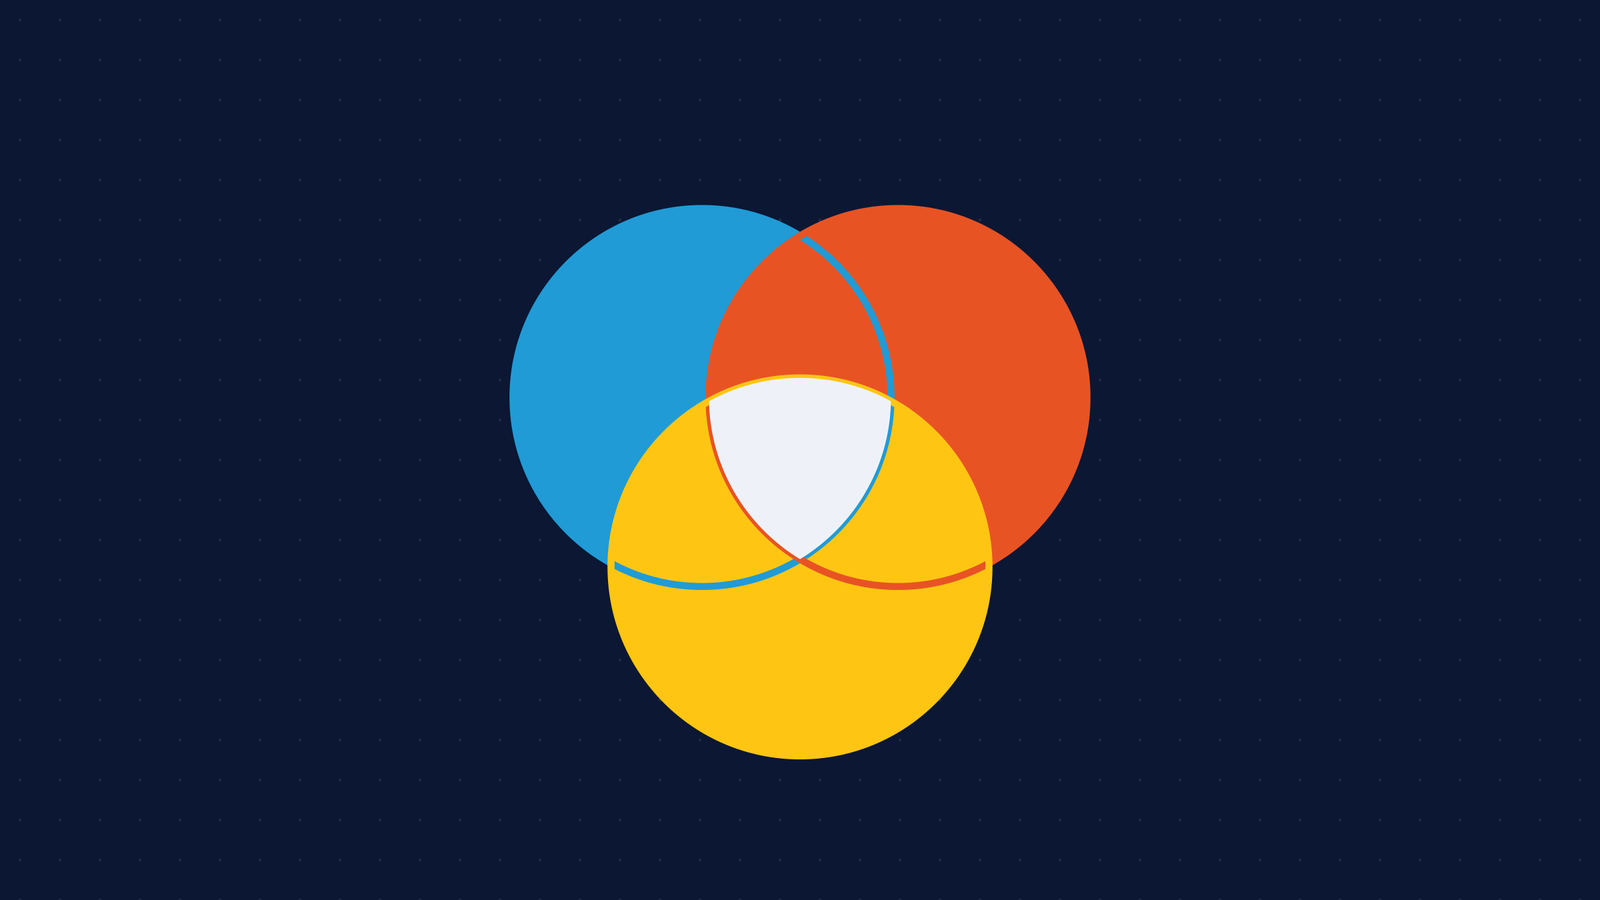
DevOps es la práctica: quienes desarrollan y quienes operan comparten la responsabilidad de llevar el software a producción y mantenerlo ahí. SRE es una forma concreta de hacer la parte de operación, con ingenieros de software, objetivos de confiabilidad y presupuestos de error. La ingeniería de plataforma construye el producto interno (caminos pavimentados, portal, plantillas) para que cada equipo haga DevOps sin reinventarlo. Una empresa que crece suele necesitar las tres, en ese orden.
Llevo más de 18 años en esto y vi cómo las tres palabras terminan siendo el título del mismo puesto. En un CV da igual. El problema aparece cuando tienes que decidir qué contratar o qué comprar, porque cada una responde una pregunta distinta.
¿Qué es DevOps, en concreto?
No es un equipo ni una herramienta. Es el acuerdo de que quien construye un servicio también se ocupa de cómo anda en producción, y de que el camino del commit a producción es automático, repetible y rápido. Los pipelines de CI/CD, la infraestructura como código y el monitoreo son la maquinaria que lo hace posible.
La prueba más clara de que funciona son las métricas de entrega de software de DORA: rendimiento (tiempo de entrega de cambios, frecuencia de despliegue, tiempo de recuperación) e inestabilidad (tasa de fallos por cambio, tasa de retrabajo). Su guía sostiene que velocidad y estabilidad no se contraponen. Si despliegas más rápido pero rompes más, todavía no hay DevOps. Cómo sacar esos números de tu propio pipeline está en el artículo sobre métricas DORA.
¿Qué es SRE y en qué se diferencia de DevOps?
Site reliability engineering, ingeniería de confiabilidad, es la respuesta de Google a la mitad operativa. La definición del libro de SRE sigue siendo la más clara: lo que pasa cuando le pides a un ingeniero de software que diseñe un equipo de operaciones.
Dos mecanismos lo separan de un equipo de operaciones tradicional. El primero es un techo al trabajo operativo: Google limita al 50 % el trabajo de “ops” de sus SRE (tickets, guardias, tareas manuales). El resto va a ingeniería que elimina la necesidad de ese trabajo, y si la operación supera el techo, el excedente vuelve al equipo de desarrollo. El segundo es el presupuesto de error. El libro sostiene que el 100 % es el objetivo de confiabilidad equivocado para casi todo: el negocio fija un objetivo de disponibilidad y el presupuesto de error es uno menos ese objetivo. Mientras quede presupuesto, se publica. Cuando se agota, primero va la confiabilidad.
SRE es entonces una forma de hacer DevOps para operar producción, con opinión propia. Puedes hacer DevOps sin SRE. Lo contrario es muy difícil, porque el presupuesto de error solo funciona si desarrollo comparte las consecuencias.
¿Qué es la ingeniería de plataforma?
Trata la infraestructura interna como un producto cuyos usuarios son tus desarrolladores. El white paper de plataformas de la CNCF la define como un conjunto integrado de capacidades presentado según lo que necesitan sus usuarios: una capa transversal para lo que muchas aplicaciones repiten.
En la práctica son caminos pavimentados. Plantillas que crean un servicio nuevo ya conectado a CI/CD, observabilidad y despliegue. Un portal, muchas veces Backstage, con el catálogo de servicios, la documentación de APIs, los responsables, el estado de los despliegues y el autoservicio en un solo lugar. Una forma estándar de llevar un release de desarrollo a producción, con compuertas, y con el escaneo de seguridad, la visibilidad de costos y las políticas puestos dentro del camino en lugar de agregados por cada equipo.
Existe por escala. Con tres equipos, cada uno puede mantener su pipeline. Con treinta, treinta pipelines parecidos pero distintos se vuelven el cuello de botella, y cada equipo gasta su tiempo en cañerías en vez de producto.
¿Cómo se comparan las tres lado a lado?
| Aspecto | DevOps | SRE | Ingeniería de plataforma |
|---|---|---|---|
| Pregunta que responde | ¿Cómo publicamos seguido y sin miedo? | ¿Qué tan confiable debe ser esto y quién lo arregla? | ¿Cómo publican muchos equipos sin rehacer las cañerías? |
| Artefacto principal | Pipelines, IaC | SLO, alertas, runbooks, postmortems | Portal, plantillas, caminos pavimentados |
| Se mide con | Métricas DORA | SLO y presupuesto de error | Adopción por los desarrolladores, más DORA entre equipos |
| Usuarios | El propio equipo | El servicio y sus usuarios | Los desarrolladores internos |
(SLO es el objetivo de confiabilidad medible, por ejemplo “99,9 % de las solicitudes responden bien”.)
¿Cuál necesita primero mi empresa?
Depende de dónde duele.
Si los releases son manuales, lentos o dan miedo, primero va lo básico de DevOps: una compuerta antes del push, CI/CD, infraestructura en código, releases por etiqueta. Sin eso, nada de lo demás se sostiene. Si los releases andan pero producción se cae y nadie se entera hasta que avisa un cliente, necesitas SRE: señales conectadas, algunos SLO que describan lo que sienten los usuarios, alertas que hayas visto disparar y runbooks. Y si cada equipo hace todo a su manera y sumar un servicio nuevo lleva semanas, necesitas ingeniería de plataforma: un camino pavimentado, un catálogo y autoservicio.
Un error frecuente es comprar un portal antes de tener lo básico de entrega (si dudas entre construirlo o comprarlo, hay un artículo aparte). Un catálogo de Backstage que lista servicios con pipelines rotos es una vista más linda del mismo problema. En The Platform Radar (en inglés) conté cómo empieza cada evaluación que hago: el líder de ingeniería me dice que su equipo tiene Kubernetes, Terraform, un pipeline de CI/CD y alguna forma de monitoreo. Una lista de herramientas te dice qué se compró. No te dice cuál de los tres trabajos se está haciendo de verdad.
¿Hace falta un equipo distinto para cada una?
Antes de tener varios equipos de producto, casi nunca. Un ingeniero de plataforma que entiende las tres puede sentar las bases si el trabajo está acotado. En MPI, una plataforma SaaS de analítica de portafolios, el esquema de los últimos 90 días es un ingeniero de plataforma de Clouditive, con un agente de IA como apoyo, junto al responsable de DevOps del cliente y unos ocho de sus ingenieros. Alcanzó para construir el pipeline de promoción, el portal y las alertas, porque los desarrolladores siguieron siendo dueños de sus servicios.
El resultado, medido en esa plataforma: los releases a producción pasaron de 1,15 por semana (abril a julio de 2026) a entre 3,7 y 4,0 en los últimos 30 días, y las fallas del pipeline de release a producción bajaron del 23 % (77 de 334, histórico) al 4 % (1 de 25 desde julio de 2026).
Lo que no funciona es nombrar a alguien “SRE” y darle solo tickets. Sin el techo al trabajo operativo, SRE vuelve a ser un equipo de operaciones tradicional con otro título.
¿SRE es lo mismo que DevOps? ¿La ingeniería de plataforma lo reemplaza?
No a las dos. DevOps es la responsabilidad compartida y la práctica de entrega. SRE es una manera concreta de operar producción dentro de esa práctica, y muchos SRE hacen trabajo de DevOps todos los días, por eso los títulos se mezclan. La ingeniería de plataforma empaqueta las prácticas de DevOps para que más equipos las usen sin construirlas. Si el equipo de plataforma deja de escuchar a los desarrolladores y empieza a imponer, vuelve a ser el viejo silo de operaciones, justo lo que DevOps quiso eliminar.
¿Por dónde empiezo?
Escribe lo que más te duele este trimestre: la velocidad de los releases, los incidentes en producción o la dispersión entre equipos. Elige el primer paso que corresponda y acótalo a dos semanas. Los paquetes que lo cubren cuestan USD 4.000 (CI/CD e IaC) y USD 5.000 (Fundamentos de IDP, y Fundamentos de SRE y observabilidad), cada uno por dos semanas.
Si la respuesta es la dispersión y estás mirando un portal interno, la página de ingeniería de plataforma explica qué construye Fundamentos de IDP y el caso que lo respalda. Cada paquete tiene su precio en precios.
Fuentes
- DORA, métricas de entrega de software, consultada el 7 de octubre de 2026.
- Libro de Google SRE, introducción, consultado el 7 de octubre de 2026.
- CNCF Platforms White Paper, consultado el 7 de octubre de 2026.