
A DORA mede a entrega de software com cinco números: lead time das mudanças (quanto tempo um commit leva até chegar em produção), frequência de deploy, tempo de recuperação de um deploy com falha, taxa de falha das mudanças e taxa de retrabalho. Cada um se mede por aplicação, com os dados do seu Git e dos seus deploys, e não com pesquisa de opinião. E eles melhoram quando cada mudança fica menor e o caminho até produção é automático.
Na The Platform Radar (em inglês) contei de um CTO que me garantiu, com toda a convicção, que o time dele media DORA. Três minutos de perguntas depois, nenhum dos dois tinha tanta certeza. Este texto é a outra metade: como tiramos cada número de dados crus em dois sistemas, e quais dois números não conseguimos tirar.
Quais são as cinco métricas DORA?
O guia atual da DORA divide o desempenho de entrega em vazão (quantas mudanças andam) e instabilidade (quão bem elas chegam).
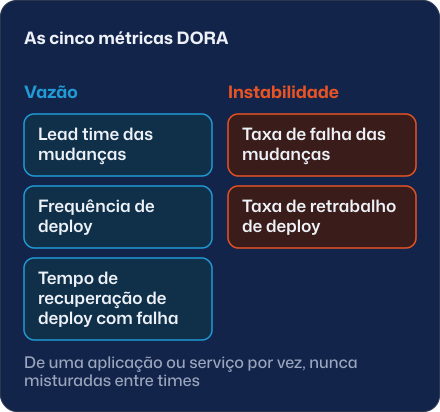
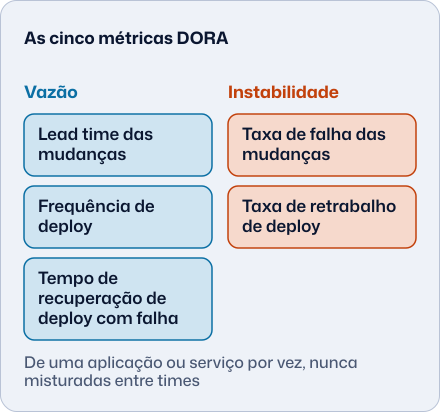
| Grupo | Métrica | O que mede |
|---|---|---|
| Vazão | Lead time das mudanças | Do momento em que a mudança entra no controle de versão até estar em produção |
| Vazão | Frequência de deploy | Quantos deploys em um período, ou o tempo entre um e outro |
| Vazão | Tempo de recuperação de deploy com falha | Quanto leva para se recuperar de um deploy que falha e exige intervenção imediata |
| Instabilidade | Taxa de falha das mudanças | Parcela dos deploys que depois exigem intervenção imediata, quase sempre um rollback ou um hotfix |
| Instabilidade | Taxa de retrabalho de deploy | Parcela dos deploys não planejados que acontecem por causa de um incidente em produção |
O modelo antigo tinha quatro métricas. O MTTR (tempo médio de restauração) foi trocado pelo tempo de recuperação de deploy com falha. Se o seu painel ainda diz “MTTR”, ele mede uma definição velha.
Como medir o lead time das mudanças?
Escolha primeiro os dois relógios, porque o número depende disso. Dá para contar a partir do commit, pela data de autoria, que é a definição da DORA. Essa data sobrevive a um rebase, então o resultado é um teto. Ou a partir do merge na branch principal, que é mais fácil de puxar da API do seu Git e não conta o tempo que a mudança ficou parada numa branch de trabalho.
Nossos dois exemplos usam relógios diferentes, então não compare um com o outro. Na MPI, uma plataforma SaaS de análise de portfólios, medimos do merge até produção: a mediana caiu de 7 a 9,5 dias para 3,4 a 4,3 dias (setembro de 2026). Na Autonomah, plataforma de publicidade com IA que construímos para um cliente, medimos do commit até produção. Para cada release SemVer, pegamos cada commit entre a tag anterior e a nova e subtraímos do fim da primeira execução bem-sucedida dessa tag em produção.
Reporte a mediana e o percentil 90, nunca a média. Nos últimos 50 releases da Autonomah (1.744 commits), a mediana é de 7,3 horas e o p90, de 23,2. O outro número que mais uso é quanto o commit mais novo de cada release espera: mediana de uns 10 minutos. Isso mostra que o pipeline não é o gargalo. A espera acontece antes de alguém cortar o release.
Como medir a frequência de deploy?
Conte os deploys bem-sucedidos em produção, e antes escreva o que é um deploy. Uma tag não é. Uma execução que falhou também não. Na Autonomah, é uma execução do pipeline que mexeu no serviço de produção e terminou com sucesso: 127 em 13 dias. Na MPI, é um release que chegou em produção pelo processo de release: 1,15 por semana de abril a julho de 2026 e entre 3,7 e 4,0 nos últimos 30 dias, umas três vezes mais.
Sempre informe a janela. A Autonomah fez 68 deploys na única semana de calendário completa que medimos, e isso não é média mensal.
Por que quase ninguém consegue medir a taxa de falha das mudanças?
Porque a métrica pede um vínculo entre um deploy e uma falha em produção, e quase ninguém registra esse vínculo. Pipeline que falhou não é mudança que falhou. Mudança que falhou chegou ao usuário e precisou de rollback ou hotfix.
Os dois exemplos têm esse buraco. Na Autonomah, 7 de 134 execuções de deploy concluídas falharam (5,2%), mas isso é falha de pipeline. Não existe um registro de incidentes que ligue um release a uma falha em produção, então a taxa de falha das mudanças e o tempo de recuperação não são mensuráveis ali, e não publicamos número nenhum. Na MPI, a queda de 23% para 4% é de falhas do pipeline de release para produção. É uma melhora real na confiabilidade com que um release chega ao destino, mas não é a taxa de falha das mudanças da DORA.
Com a velocidade de rollback acontece o mesmo. Na MPI ensaiamos de ponta a ponta um rollback por re-promoção em desenvolvimento: 72 segundos para voltar e 124 para avançar de novo. Ninguém mediu um rollback em produção, então esse número mostra o que o mecanismo consegue. Quanto leva para recuperar a produção segue sem medição.
Se você quer essas duas métricas, acrescente um campo ao modelo de incidente: “causado pelo release vX.Y.Z”. Custa pouco e muda tudo.
Como melhorar as métricas DORA?
O conselho da DORA começa pelo tamanho do lote: mudanças pequenas andam mais rápido e são mais fáceis de recuperar quando falham. O que mexeu nos números da MPI foi tirar espera. Ninguém precisou trabalhar mais rápido.
Cada merge chega em desenvolvimento sem que alguém aperte um botão. Dali, o Kargo sobre o Argo CD promove o release para produção com uma hora de observação e verificações (smoke tests na borda, checagem de reinícios e disponibilidade dos pods, proporção de erros HTTP 5xx), em vez de uma aprovação por mensagem no chat. As migrações de banco rodam num hook antes da sincronização, com um snapshot automático antes, então viajam com o release e deixam de ser um passo manual à parte. E sete passos manuais mais uma certificação em quatro partes viraram uma ação única de promoção, que executa um template automatizado de 79 passos. Não medimos o tempo que isso economizou e não vou inventar um número.
O primeiro release pelo pipeline novo chegou em produção em umas duas horas, uma delas de observação. É um release só: serve para ver o que o caminho permite, e ainda não há mediana. Na Autonomah o ciclo é curto de propósito: cada tag SemVer compila, migra e faz o deploy por digest (a impressão digital da imagem), e o pipeline leva uma mediana de 5,5 minutos.
Que erros evitar?
O guia da DORA lista vários. Três aparecem em quase todo projeto em que entramos.
O primeiro é transformar a métrica em meta. “Todo time faz deploy diário até o quarto trimestre” convida a inflar a contagem. Use os números para achar a restrição; ranquear times com eles só os estraga. O segundo é misturar aplicações: um lead time da empresa inteira junta um monolito que sobe uma vez por mês com um serviço que sobe de hora em hora, e a média não descreve nenhum dos dois. O terceiro é medir em vez de melhorar. Construir integrações para ter números perfeitos pode custar mais que a primeira melhoria, e a própria DORA sugere começar por conversas ou pelo Quick Check dela.
O quarto erro é meu: publicar um número sem a população dele. Cada cifra acima diz a janela e o que foi contado. Um painel que não sabe dizer isso é decoração.
Velocidade e estabilidade andam mesmo juntas?
A DORA diz que sim, e que as equipes de melhor desempenho vão bem nas cinco métricas. Nossos dados concordam na parte que conseguimos ver: na MPI a frequência de releases mais que triplicou enquanto as falhas do pipeline de release caíam de 23% para 4%. Da instabilidade não dá para afirmar nada, porque as falhas de mudança em produção nunca foram registradas de um jeito que desse para contar.
Por onde começar?
Antes de ligar para alguém, escolha um serviço, puxe os merges e deploys dos últimos 90 dias e calcule a mediana do lead time. Se ela vier em dias, olhe primeiro o caminho de promoção. Depois acrescente aos seus incidentes o campo “causado pelo release”, e no próximo trimestre a taxa de falha das mudanças já será mensurável.
Se o gargalo é o caminho de promoção, isso já é engenharia de plataforma: pipelines de promoção, verificações e um portal que mostra o que está publicado e onde. A página de engenharia de plataforma explica como fazemos, e cada pacote com preço fixo está em preços.
Fontes
- DORA, “DORA’s software delivery performance metrics”, consultada em 7 de outubro de 2026. O guia recomenda aplicar as métricas a uma aplicação ou serviço de cada vez.
- Números da MPI e da Autonomah: medições próprias nos repositórios e pipelines de cada uma, outubro de 2026.