
DORA mide la entrega de software con cinco métricas: lead time de los cambios (cuánto tarda un cambio desde el commit hasta producción), frecuencia de despliegue, tiempo de recuperación de un despliegue fallido, tasa de cambios fallidos y tasa de retrabajo. Se miden por aplicación, con los datos de tu repositorio y de tus despliegues, no con una encuesta. Y mejoran cuando cada cambio es más chico y el camino a producción se automatiza.
Conté en The Platform Radar (en inglés) el caso de un CTO que me aseguró, muy convencido, que su equipo medía DORA. Tres minutos de preguntas después, ninguno de los dos estaba tan seguro. Esto es la otra mitad: cómo sacamos cada número de datos crudos en dos sistemas, y los dos que no pudimos sacar.
¿Cuáles son las cinco métricas DORA?
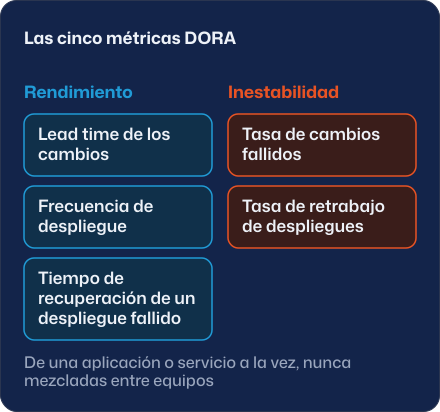
La guía vigente de DORA separa el desempeño de entrega en rendimiento (cuántos cambios avanzan) e inestabilidad (qué tan bien llegan).
| Grupo | Métrica | Qué mide |
|---|---|---|
| Rendimiento | Lead time de los cambios | Desde que un cambio entra al control de versiones hasta que está en producción |
| Rendimiento | Frecuencia de despliegue | Cantidad de despliegues en un período, o el tiempo entre uno y otro |
| Rendimiento | Tiempo de recuperación de un despliegue fallido | Cuánto tarda en recuperarse un despliegue que falla y exige intervención inmediata |
| Inestabilidad | Tasa de cambios fallidos | Proporción de despliegues que después exigen intervención inmediata, casi siempre un rollback o un hotfix |
| Inestabilidad | Tasa de retrabajo de despliegues | Proporción de despliegues no planificados que ocurren por un incidente en producción |
El modelo tenía cuatro métricas. El MTTR se reemplazó por el tiempo de recuperación de un despliegue fallido, así que si tu tablero todavía dice “MTTR”, mide una definición vieja.
¿Cómo se mide el lead time de los cambios?
Primero elige los dos momentos, porque de eso depende el número. Puedes contar desde el commit, con la fecha de autor, que es la definición de DORA. Esa fecha se conserva aunque reescribas el historial con un rebase, así que el número puede salir inflado: tómalo como un máximo. O desde el merge a la rama principal, que es más fácil de sacar de la API de tu proveedor de Git y no cuenta el tiempo que el cambio pasó en una rama de trabajo.
Nuestros dos ejemplos usan relojes distintos, así que no los compares entre sí. En MPI, una plataforma SaaS de analítica de portafolios, medimos de merge a producción. En Autonomah, una plataforma de publicidad con IA que construimos para un cliente, medimos de commit a producción: para cada release tomamos los commits entre el tag anterior y el nuevo y medimos cuánto pasó desde cada uno hasta que ese tag corrió con éxito en producción por primera vez.
Reporta la mediana y el percentil 90, nunca el promedio. En los últimos 50 releases de Autonomah la mediana es de 7,3 horas y el percentil 90, de 23,2. El otro número que más me sirve es cuánto espera el commit más nuevo de cada release: una mediana de unos 10 minutos. Eso dice que el pipeline no es el cuello de botella. La espera ocurre antes de cortar el release.
¿Cómo se mide la frecuencia de despliegue?
Cuenta los despliegues exitosos a producción, y antes escribe qué es un despliegue. Un tag no lo es. Una ejecución que falló, tampoco. En Autonomah es una ejecución del pipeline que movió el servicio de producción y terminó en éxito: 127 en 13 días. En MPI es un release que llegó a producción por el proceso normal: 1,15 por semana de abril a julio de 2026 y entre 3,7 y 4,0 en los últimos 30 días, unas tres veces más.
Indica siempre la ventana. Autonomah hizo 68 despliegues en la única semana calendario completa que medimos, y eso no es un promedio mensual.
¿Por qué casi nadie puede medir la tasa de cambios fallidos?
Porque necesita un vínculo entre un despliegue y una falla en producción, y casi nadie lo registra. Una ejecución fallida del pipeline no es un cambio fallido. Un cambio fallido llegó a los usuarios y necesitó un rollback o un hotfix.
En los dos ejemplos hay ese hueco. En Autonomah fallaron 7 de 134 ejecuciones de despliegue completadas (5,2 %), pero eso es falla del pipeline. No hay un registro de incidentes que ate un release a una falla en producción, así que la tasa de cambios fallidos y el tiempo de recuperación no se pueden medir ahí, y no publicamos ningún número. En MPI, la baja del 23 % al 4 % corresponde a fallas del pipeline de release a producción. Es una mejora real, pero mide si el release llega a producción, y eso no es la tasa de cambios fallidos de DORA.
Con la velocidad de rollback pasa lo mismo. En MPI ensayamos de punta a punta un rollback por re-promoción en desarrollo: 72 segundos hacia atrás y 124 hacia adelante. Nadie midió un rollback en producción, así que esa cifra dice lo que el mecanismo puede hacer. Cuánto demora recuperar producción sigue sin medirse.
Si quieres estas dos métricas, agrega un campo a tu plantilla de incidentes: “causado por el release vX.Y.Z”. Cuesta poco y marca toda la diferencia.
¿Cómo se mejoran las métricas DORA?
El consejo de DORA parte por el tamaño del lote: los cambios chicos avanzan más rápido y es más fácil recuperarse si fallan. Lo que movió los números en MPI fue quitar esperas. Nadie tuvo que trabajar más rápido.
Cada merge llega a desarrollo sin que nadie apriete nada. De ahí, Kargo sobre Argo CD promueve el release a producción con una hora de observación y controles de verificación (pruebas de humo en el borde, chequeos de reinicios y disponibilidad de los pods, proporción de errores HTTP 5xx), en lugar de una aprobación por chat. Las migraciones de base de datos corren en un hook previo a la sincronización, con una copia automática de la base antes, así que viajan con el release y dejan de ser un paso manual aparte. Y siete pasos manuales más una certificación en cuatro partes pasaron a ser una sola acción de promoción que ejecuta una plantilla automatizada de 79 pasos. No medimos cuánto tiempo ahorró.
El primer release por el nuevo pipeline llegó a producción en unas dos horas, una de ellas de observación. Es un solo release: sirve para ver lo que el camino permite, y todavía no hay mediana. En Autonomah el ciclo es corto por diseño: cada tag SemVer compila, migra y despliega por digest (la huella única de la imagen), y el pipeline demora una mediana de 5,5 minutos.
¿Qué errores conviene evitar?
La guía de DORA enumera varios. Tres aparecen en casi todos los proyectos a los que entramos.
El primero es convertir la métrica en objetivo. “Todos los equipos despliegan a diario antes del cuarto trimestre” invita a inflar el conteo. Usa los números para encontrar la restricción; rankear equipos con ellos los arruina. El segundo es mezclar aplicaciones: un lead time de toda la organización junta un monolito que sale una vez al mes con un servicio que sale cada hora, y el promedio no describe a ninguno. El tercero es medir en vez de mejorar. Construir integraciones para tener números perfectos puede costar más que la primera mejora, y la propia DORA sugiere empezar con conversaciones o con su Quick Check.
Mi aporte es un cuarto error: publicar un número sin su población. Cada cifra de arriba dice su ventana y qué contó. Un tablero que no puede decirte eso es decoración.
¿De verdad velocidad y estabilidad van juntas?
DORA dice que sí, y que los equipos de mejor desempeño salen bien en las cinco métricas. Nuestros datos coinciden en la parte que podemos ver: en MPI la frecuencia de releases se triplicó más o menos mientras las fallas del pipeline de release bajaban del 23 % al 4 %. De la inestabilidad no podemos afirmar nada, porque las fallas de cambios en producción nunca quedaron registradas de forma que se pudieran contar.
¿Por dónde empiezo?
Antes de llamar a nadie, elige un servicio, saca los merges y despliegues de los últimos 90 días y calcula la mediana del lead time. Si la mides en días, mira primero el camino de promoción. Después agrega a tus incidentes el campo “causado por el release”, y el próximo trimestre la tasa de cambios fallidos ya se podrá medir.
Si el cuello de botella es el camino de promoción, eso ya es ingeniería de plataforma: pipelines de promoción, controles y un portal que muestre qué está desplegado y dónde. La página de ingeniería de plataforma explica cómo lo hacemos, y cada paquete con su precio fijo está en precios.
Fuentes
- DORA, “DORA’s software delivery performance metrics”, consultada el 7 de octubre de 2026. La guía recomienda aplicar las métricas a una aplicación o servicio por vez.
- Cifras de MPI y Autonomah: mediciones propias sobre sus repositorios y pipelines, octubre de 2026.