
O Argo CD mantém um cluster Kubernetes igual ao que o Git diz, mas não decide qual versão pertence a cada ambiente. Isso é com o Kargo: ele empacota um release como freight, promove para a etapa seguinte só quando as verificações passam e, para voltar atrás, promove de novo o freight anterior. Com as duas ferramentas você tem deploy automático em desenvolvimento, uma hora de observação, verificações antes de produção e migrações dentro do release.
Montamos esse pipeline para a MPI, uma plataforma SaaS de análise de portfólios em AWS EKS. Os números abaixo são de lá.
O que o Argo CD faz e o que não faz?
O Argo CD vigia um repositório com o estado desejado de uma aplicação (charts Helm, manifests, values) e leva o cluster até esse estado. Se alguém mexe no cluster na mão, ele mostra a diferença e pode desfazê-la. A documentação o define como uma ferramenta declarativa de entrega contínua com GitOps.
O que ele não decide é qual versão roda em cada ambiente. Se produção deve receber a imagem que passou uma hora saudável em desenvolvimento, alguém precisa escrever essa versão no estado desejado de produção na hora certa. Sem uma ferramenta de promoção, esse alguém é uma pessoa editando um arquivo de values, ou um job de CI com um script enorme e uma aprovação por mensagem no chat. Já vi as duas. A aprovação por chat é o controle mais fraco que existe, e todo mundo sabe.
O que o Kargo acrescenta?
Promoção, só isso. O Kargo não faz deploy: ele grava a promoção no Git e deixa o Argo CD sincronizar. O modelo dele tem três peças.
O warehouse observa repositórios de imagens, Git e charts Helm e empacota as revisões novas. O freight é o pacote de revisões concretas (imagens e manifests) que precisam viajar juntas: um release é um freight. O stage é um destino de promoção, em geral um ambiente. Eles se encadeiam, e por isso um freight só chega a produção se passou pelos anteriores.
O Git continua sendo o registro do que roda onde. Cada promoção é um commit que você consegue ler.
Como um release vai de desenvolvimento a produção?
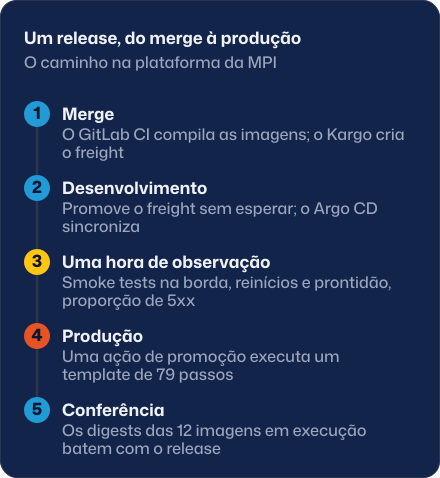
Na MPI são dois ambientes, em contas AWS separadas. O caminho é este:
- O GitLab CI compila e publica as imagens.
- O Kargo vê as revisões novas e cria o freight.
- O stage de desenvolvimento o promove sem esperar ninguém e o Argo CD sincroniza.
- O freight fica uma hora em desenvolvimento enquanto a plataforma o observa.
- Antes de liberar produção, ele precisa passar por smoke tests na borda, verificações de reinício e de prontidão dos pods (se estão aptos a receber tráfego) e um controle da proporção de erros do servidor (respostas HTTP 5xx). Se um falha, não avança.
- Uma única ação de promoção executa um template automatizado de 79 passos, que substituiu sete passos manuais e uma lista de certificação em quatro partes.
- Alguém confere se os digests (a impressão digital de cada imagem de contêiner) em execução em produção são os do release. No primeiro release por esse caminho, as 12 imagens de serviço bateram.
Esse primeiro release chegou a produção em umas duas horas, uma delas de observação. É um caso, não uma mediana. E não medimos quanto tempo o template de 79 passos economiza, então não ponho número.
Que verificações barram de verdade um release ruim?
Uma verificação só vale se pode dizer não. Ficamos com três, baratas de rodar, e cada uma pega uma falha diferente.
Os smoke tests chamam os endpoints públicos pelo caminho real de entrada. Pegam o release que sobe bem, mas não consegue atender tráfego pelo gateway. As verificações de reinício e de prontidão acham serviços que caem em loop ou que nunca ficam prontos, coisa que uma sincronização bem-sucedida não mostra. E a proporção de erros 5xx compara as falhas do servidor com o tráfego durante a observação, o que pega o release que responde, mas responde errado.
Com isso, produção já consegue barrar um release ruim. É a propriedade que se testa antes de confiar em qualquer controle: rode-o uma vez contra um caso que deveria falhar. Contra releases saudáveis tudo passa.
Como rodar migrações de banco com GitOps?
As migrações são o ponto em que muito pipeline GitOps volta para uma janela manual. Nós as mantemos dentro do release. Elas rodam como um Job do Kubernetes com o hook PreSync do Argo CD, ou seja, antes de aplicar os manifests novos, e antes de começar tira-se um snapshot automático do banco. Se a migração falha, o hook falha e o Argo CD para a sincronização inteira. A versão anterior continua rodando contra um banco que ela ainda entende.
Um hook mínimo é assim:
apiVersion: batch/v1
kind: Job
metadata:
  name: db-migrate
  annotations:
    argocd.argoproj.io/hook: PreSync
    argocd.argoproj.io/hook-delete-policy: BeforeHookCreation
spec:
  backoffLimit: 0
  template:
    spec:
      restartPolicy: Never
      containers:
        - name: migrate
          image: registry.example.com/app@sha256:<digest>
          command: ["npm", "run", "migrate"]
O backoffLimit: 0 importa. Uma migração que falha uma vez deve parar o release. Tentar de novo sobre um schema migrado pela metade piora tudo. E as migrações precisam continuar compatíveis com a versão que está rodando, porque um rollback não as desfaz.
Como funciona o rollback por nova promoção?
Não se desfaz um deploy: promove-se de novo o freight anterior. O Kargo grava as revisões antigas no Git, o Argo CD as sincroniza e rodam as mesmas verificações de qualquer release.
Ensaiamos isso de ponta a ponta em desenvolvimento. Voltar levou de 72 a 77 segundos, avançar de novo de 120 a 124, e a verificação completa ficou verde em 15 a 17 minutos. São tempos de desenvolvimento. Ainda não fizemos um rollback em produção e não vou apresentar esse número como tempo de recuperação.
O que importa é ter ensaiado. Um caminho de rollback que nunca foi executado é uma hipótese.
O que mudou nos números de entrega?
Medido na plataforma da MPI:
| Métrica | Antes | Depois |
|---|---|---|
| Releases em produção por semana | 1,15 (abril a julho de 2026) | 3,7 a 4,0 (últimos 30 dias) |
| Lead time mediano, do merge até produção | 7 a 9,5 dias (abril a julho) | 3,4 a 4,3 dias (setembro) |
| Pipelines de release em produção com falha | 23% (77 de 334, histórico) | 4% (1 de 25 desde julho de 2026) |
A última linha mede falhas do pipeline, que são outra coisa que a taxa de falha das mudanças da DORA. A diferença está no texto sobre métricas DORA.
Quando o Kargo é mais do que você precisa?
Com um ambiente só, ou com um único serviço que faz deploy direto do CI e funciona para você, o Argo CD sozinho basta. O Kargo se justifica quando vários serviços precisam avançar juntos por dois ou mais ambientes, quando você quer observação e verificações entre eles e quando a pergunta “o que roda em produção e como chegou lá” deve ser respondida com o Git na mão.
Por onde começar?
Pelas verificações; a ferramenta vem depois. Anote que checagens uma pessoa faz hoje antes de cada release em produção: cada uma é uma candidata a controle. Transforme-as em verificações que possam falhar e só então ligue a promoção.
Se antes é preciso refazer o seu CI/CD e a infraestrutura como código, o pacote custa US$ 4.000 por duas semanas e está no nosso serviço de DevOps. Todos os preços estão em preços.
Fontes
- Documentação do Argo CD e Sync Phases and Waves, consultadas em 7 de outubro de 2026.
- Conceitos centrais do Kargo, consultado em 7 de outubro de 2026.
- Números da MPI: medição própria na plataforma, outubro de 2026.