
Argo CD mantiene un clúster de Kubernetes igual a lo que dice Git, pero no decide qué versión le toca a cada entorno. Eso lo hace Kargo: empaqueta un release como freight, lo promueve a la siguiente etapa solo cuando los controles dan verde y, para volver atrás, promueve de nuevo el freight anterior. Con las dos herramientas tienes deploy automático a desarrollo, una hora de observación, controles antes de producción y migraciones dentro del release.
Armamos este pipeline para MPI, una plataforma SaaS de analítica de portafolios en AWS EKS. Los números de abajo son de ahí.
¿Qué hace Argo CD y qué no hace?
Argo CD vigila un repositorio con el estado deseado de una aplicación (charts de Helm, manifiestos, valores) y lleva el clúster hacia ese estado. Si alguien toca el clúster a mano, muestra la diferencia y puede revertirla. Su documentación lo define como una herramienta declarativa de entrega continua con GitOps.
Lo que no decide es qué versión corre en cada entorno. Si producción debe recibir la imagen que pasó una hora sana en desarrollo, alguien tiene que escribir esa versión en el estado deseado de producción en el momento justo. Sin una herramienta de promoción, ese alguien es una persona editando un archivo de valores, o un job de CI con un script larguísimo y una aprobación por chat. He visto las dos. La aprobación por chat es el control más débil que existe, y todos lo saben.
¿Qué agrega Kargo sobre Argo CD?
Promover, nada más. Kargo no despliega: escribe la promoción en Git y deja que Argo CD la sincronice. Su modelo tiene tres piezas.
El warehouse vigila repositorios de imágenes, Git y charts de Helm, y empaqueta las revisiones nuevas. El freight es el paquete de revisiones concretas (imágenes y manifiestos) que deben viajar juntas: un release es un freight. La stage es un destino de promoción, normalmente un entorno. Se encadenan, y por eso un freight llega a producción solo si pasó por las anteriores.
Git sigue siendo el registro de qué corre dónde. Cada promoción es un commit que puedes leer.
¿Cómo pasa un release de desarrollo a producción?
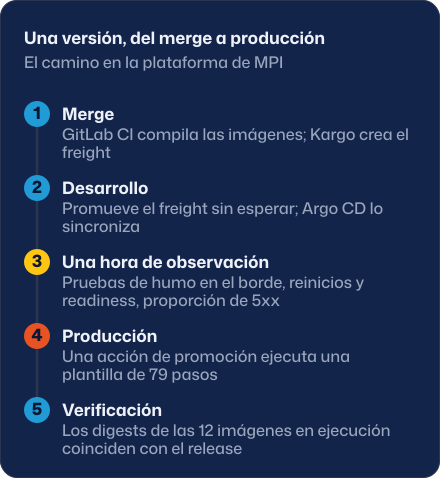
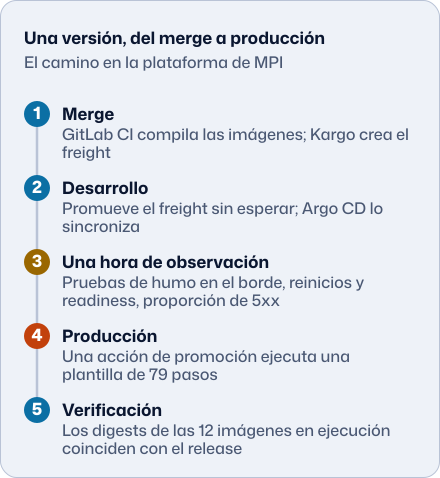
En MPI hay dos entornos en cuentas de AWS separadas. El camino es este:
- GitLab CI compila y publica las imágenes.
- Kargo detecta las revisiones nuevas y crea el freight.
- La stage de desarrollo lo promueve sin esperar a nadie y Argo CD lo sincroniza.
- El freight se queda una hora en desarrollo mientras la plataforma lo vigila.
- Antes de habilitar producción tiene que pasar pruebas de humo en el borde, chequeos de reinicios y de que los pods estén listos para recibir tráfico, y un control de la proporción de errores del servidor (respuestas HTTP 5xx). Si falla uno, no avanza.
- Una sola acción de promoción ejecuta una plantilla automatizada de 79 pasos, que reemplazó siete pasos manuales y una lista de certificación en cuatro partes.
- Alguien verifica que los digests (la huella única de cada imagen de contenedor) que corren en producción son los del release. En el primer release por este camino, las 12 imágenes de servicio coincidían.
Ese primer release llegó a producción en unas dos horas, una de ellas de observación. Es un caso, no una mediana. Y no medimos cuánto tiempo ahorra la plantilla de 79 pasos, así que no pongo una cifra.
¿Qué controles frenan de verdad un release malo?
Un control vale si puede decir que no. Dejamos tres, baratos de correr, y cada uno atrapa una falla distinta.
Las pruebas de humo llaman a los endpoints públicos por el camino real de entrada. Detectan el release que arranca bien pero no puede atender tráfico a través del gateway. Los chequeos de reinicios y de disponibilidad encuentran servicios que se caen en bucle o que nunca quedan listos, algo que una sincronización exitosa no muestra. La proporción de errores 5xx compara las fallas del servidor con el tráfico durante la observación y atrapa al release que responde, pero responde mal.
Con esto producción ya puede bloquear un release malo. Esa es la propiedad que hay que probar antes de confiar en cualquier control: córrelo una vez contra un caso que debería fallar. Con releases sanos todo pasa.
¿Cómo se corren migraciones de base de datos con GitOps?
Las migraciones son donde muchos pipelines GitOps vuelven a una ventana manual. Nosotros las dejamos dentro del release. Corren como un Job de Kubernetes con el hook PreSync de Argo CD, así que se ejecutan antes de aplicar los manifiestos nuevos, y antes de empezar se toma un snapshot automático de la base. Si la migración falla, el hook falla y Argo CD detiene toda la sincronización. La versión anterior sigue corriendo contra una base que todavía entiende.
Un hook mínimo se ve así:
apiVersion: batch/v1
kind: Job
metadata:
  name: db-migrate
  annotations:
    argocd.argoproj.io/hook: PreSync
    argocd.argoproj.io/hook-delete-policy: BeforeHookCreation
spec:
  backoffLimit: 0
  template:
    spec:
      restartPolicy: Never
      containers:
        - name: migrate
          image: registry.example.com/app@sha256:<digest>
          command: ["npm", "run", "migrate"]
backoffLimit: 0 importa. Una migración que falla una vez debe frenar el release. Reintentar sobre un esquema migrado a medias lo empeora. Y las migraciones tienen que seguir siendo compatibles con la versión que está corriendo, porque un rollback no las deshace.
¿Cómo funciona el rollback por re-promoción?
No se deshace un despliegue: se vuelve a promover el freight anterior. Kargo escribe las revisiones viejas en Git, Argo CD las sincroniza y corren los mismos controles que en cualquier release.
Lo ensayamos de punta a punta en desarrollo. Volver atrás tomó de 72 a 77 segundos, volver a avanzar de 120 a 124, y la verificación completa quedó en verde a los 15 a 17 minutos. Son tiempos de desarrollo. Todavía no hicimos un rollback en producción y no voy a presentar esa cifra como un tiempo de recuperación.
Lo que importa es haberlo ensayado. Un camino de rollback que nunca se ejecutó es una hipótesis.
¿Qué cambió en los números de entrega?
Medido en la plataforma de MPI:
| Métrica | Antes | Después |
|---|---|---|
| Releases a producción por semana | 1,15 (abril a julio de 2026) | 3,7 a 4,0 (últimos 30 días) |
| Mediana del lead time, de merge a producción | 7 a 9,5 días (abril a julio) | 3,4 a 4,3 días (septiembre) |
| Pipelines de release a producción fallidos | 23 % (77 de 334, histórico) | 4 % (1 de 25 desde julio de 2026) |
La última fila mide fallas del pipeline, que son otra cosa que la tasa de cambios fallidos de DORA. La diferencia está en el artículo sobre métricas DORA.
¿Cuándo Kargo es más de lo que necesitas?
Con un solo entorno, o un único servicio que despliega directo desde CI y te funciona, alcanza con Argo CD. Kargo se justifica cuando varios servicios tienen que avanzar juntos por dos o más entornos, cuando quieres observación y controles entre ellos y cuando la pregunta “qué corre en producción y cómo llegó ahí” debe responderse con Git en la mano.
¿Por dónde empiezo?
Por los controles; la herramienta viene después. Anota qué chequeos hace hoy una persona antes de cada release a producción: cada uno es un control candidato. Conviértelos en verificaciones que puedan fallar y después conecta la promoción.
Si antes hay que rehacer tu CI/CD y tu infraestructura como código, el paquete cuesta USD 4.000 por dos semanas y lo cubre nuestro servicio de DevOps. Todos los precios están en precios.
Fuentes
- Documentación de Argo CD y Sync Phases and Waves, consultadas el 7 de octubre de 2026.
- Conceptos básicos de Kargo, consultado el 7 de octubre de 2026.
- Cifras de MPI: medición propia sobre su plataforma, octubre de 2026.