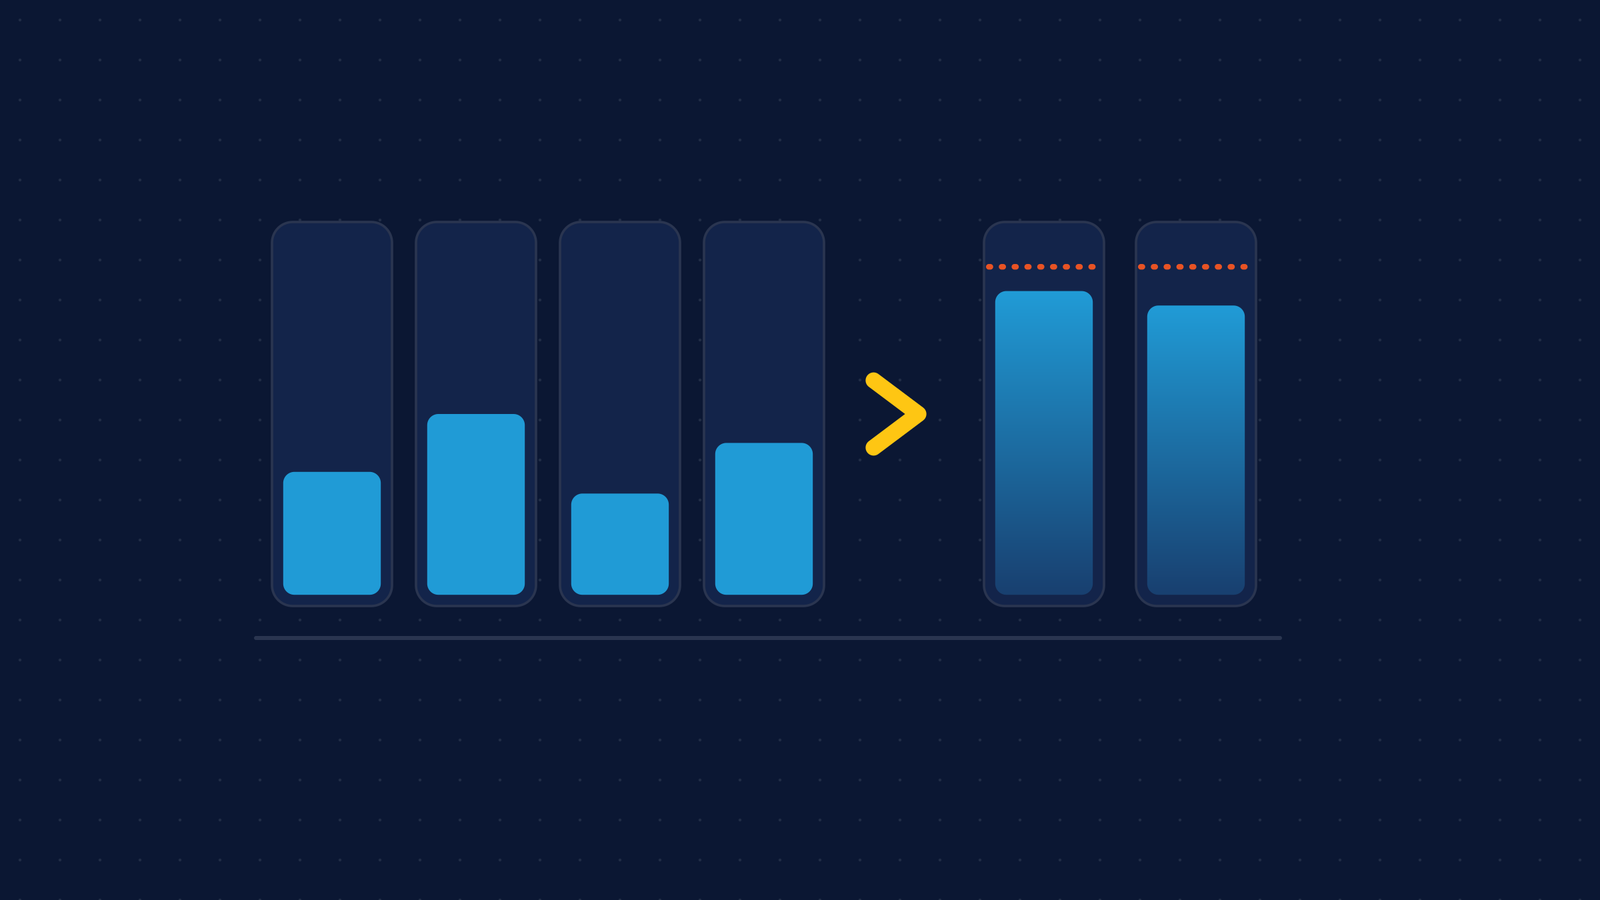
Comece pela conta, não pelo cluster. Dê a cada linha um dono, um serviço ou um time. Depois compare o que cada carga de trabalho solicita com o pico histórico dela, não com a média, porque o que você paga são os requests. E então decida quanto a consolidação de nós pode trabalhar, porque ela economiza movendo os seus pods. Essa é a ordem que seguimos nas auditorias de custo de nuvem e de clusters, inclusive na de uma plataforma SaaS fintech que uso abaixo.
Primeiro, um limite. O caso desse projeto cita auditorias de custo e uma visão de custo por serviço, e nenhum número de economia. Este artigo também não vai inventar um. O que o caso publica é o stack (AWS EKS com Karpenter), as auditorias e um conjunto de correções de estabilidade que ficam no mesmo botão que o custo. Vale ler.
De quem é cada linha da conta?
Antes de mudar qualquer coisa, atribua cada linha a um serviço ou a um time. Um custo sem dono não dá para cortar com segurança, porque você não sabe o que depende dele. Se quer isso feito na sua própria conta, vendemos uma Revisão de custos na nuvem a preço fixo.
Nessa plataforma fintech, o custo por serviço fica no portal interno de desenvolvedores, ao lado do status de deploy do mesmo serviço, e os valores vêm direto da API de cobrança da nuvem. O ponto de colocá-lo lá não é o gráfico. É que quem muda um serviço vê o que ele custa no lugar onde já está olhando.
Se você não tem um portal, faça o mesmo numa planilha. Exporte a conta do mês passado agrupada por serviço e por tag, e conte as linhas sem dono. Deixe essas numa linha chamada “sem atribuição”, nunca arredondadas para dentro de “outros”. Se essa linha é grande, pare de otimizar e arrume primeiro as tags. Tudo o que vem depois supõe que você sabe a quem perguntar. Para o quadro geral, veja o que é FinOps.
Como dimensionar por picos históricos?
Por causa de como o Kubernetes agenda. O scheduler coloca um pod conforme a soma dos requests de recursos em um nó. A documentação do Kubernetes diz que, mesmo quando o uso real de um nó é bem baixo, o scheduler ainda recusa um pod cujo request não cabe. Os requests definem quantos nós você roda, e os nós são a conta.
Por isso o ajuste que parece mais barato, baixar os requests para a média, é também o perigoso. Os limites de memória são aplicados pelo kernel com kills por falta de memória (OOM), e a mesma página diz que um contêiner que usa mais do que o limite de memória pode ser encerrado. A média é o número que acaba em pod morto. Dimensione pelo máximo histórico, mais uma folga que você escolheu de propósito.
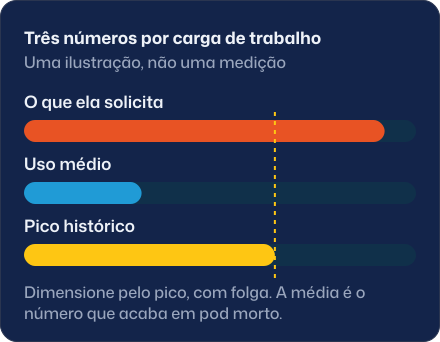
Dois detalhes decidem se funciona. A janela precisa incluir o pior evento que você tem: um relatório de fim de mês, o fechamento do trimestre, uma promoção. E você agrega por carga de trabalho, não pelo nome do pod, porque os nomes mudam a cada rollout e esconderiam o histórico. No Prometheus ou num armazenamento compatível, com retenção suficiente:
max by (namespace, container) (
  max_over_time(
    container_memory_working_set_bytes{container!=""}[90d]
  )
)
/
max by (namespace, container) (
  kube_pod_container_resource_requests{resource="memory"}
)
Uma razão bem abaixo de 1 é folga que você está pagando. Uma perto de 1 ou maior é uma carga sem margem, custe o que custar. Leia a lista de cima para baixo, confira as maiores com os donos e mude uma carga de cada vez.
A forma de carga que mais sofre com isso é a que tem picos. O caso fintech cita uma falha de falta de memória num relatório grande que foi diagnosticada e corrigida, e jobs longos de relatórios que agora terminam com drenagem graciosa. Não estou dizendo que aquela falha foi erro de dimensionamento: a página não diz. Estou dizendo que cargas de relatório são onde a média mente para você.
O que a consolidação do Karpenter economiza e o que ela quebra?
Consolidação é o Karpenter removendo nós para reduzir custo. A documentação lista três casos: um nó está vazio, as cargas dele cabem em outros nós, ou ele pode ser trocado por uma variante mais barata. Por padrão um NodePool usa WhenEmptyOrUnderutilized com consolidateAfter: 0s, que a documentação apresenta como a escolha de quem quer o menor custo possível e aceita a interrupção de pods que isso exige. WhenEmpty é o extremo conservador, e colocar consolidateAfter em Never desliga a consolidação daquele NodePool.
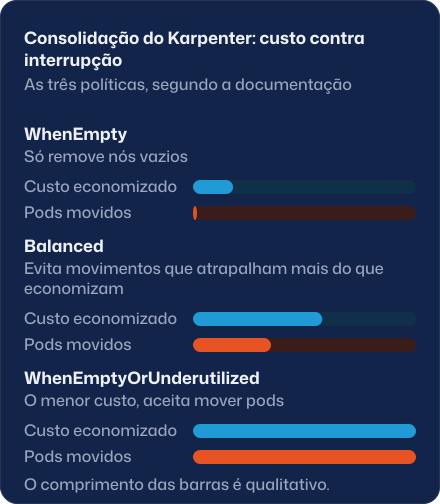
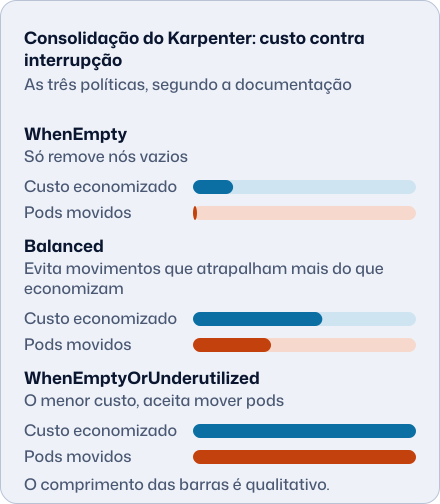
Economia e interrupção vêm do mesmo mecanismo, então não dá para ter uma sem a outra. O caso fintech lista três correções exatamente nesse botão. A consolidação de nós deixou de recriar o armazenamento de logs umas três vezes por dia. O autoscaling deixou de derrubar de uma vez a maior parte dos pods de relatórios. E os jobs longos de relatórios terminam com drenagem graciosa. A página não diz qual ajuste do Karpenter mudou, e não vou chutar.
O que eu faria em qualquer cluster:
- Coloque cargas com estado e jobs longos em um NodePool próprio, com política conservadora.
- Marque com a anotação
karpenter.sh/do-not-disruptos pods que não podem se mover. A documentação diz que dá para tratá-la como um PodDisruptionBudget de um único pod. - Defina orçamentos de interrupção. Se você não definir nenhum, o Karpenter usa por padrão um de 10% dos nós.
- Depois de ligar a consolidação, conte quantas vezes por dia cada pod com estado é recriado. Esse número deveria ser um que você escolheu, não um que você descobriu.
O que não esperar?
Uma porcentagem. Não prometemos uma antes de ler a sua conta, e uma economia aparece na fatura ou não é economia, então é lá que medimos. Além disso, a conta se move com o uso, e por isso comparar um único mês antes e depois prova pouco. Compare o custo por unidade de trabalho, como o custo por relatório ou por cliente ativo, na mesma janela.
As revisões de custo fazem parte da consultoria cloud. O Discovery custa US$ 7.000 por 1 a 4 semanas quando o destino ainda está aberto, e CI/CD e IaC custa US$ 4.000 por 2 semanas quando é preciso construir ou refazer a infraestrutura como código. Por hora, um Sênior custa US$ 45 a 50 e um Líder ou Arquiteto, US$ 55 a 60. A página de preços tem tudo, e valor hora de desenvolvedor nearshore em 2026 explica como orçar horas.
Os artigos sobre Argo CD e Kargo e sobre Grafana vs Datadog cobrem dois vizinhos deste: como os releases chegam ao cluster e quanto custa a observabilidade.
O que dá para fazer em 30 minutos?
Escolha as suas três maiores cargas de trabalho. Rode a consulta do pico para cada uma, anote a razão e o dono, e exporte a conta do mês passado agrupada por tag. A quantidade de linhas sem dono e as razões mostram por onde uma auditoria começaria.
Fontes
- Karpenter, Disruption: políticas de consolidação,
consolidateAfter, orçamentos de interrupção por NodePool e a anotaçãodo-not-disrupt. Consultado em 9 de outubro de 2026 (sha256 75da76dc…). - Kubernetes, Resource Management for Pods and Containers: agendamento por requests e limites de memória aplicados com kills por OOM. Consultado em 9 de outubro de 2026 (sha256 8eee4a66…).
- Nosso caso: pipeline de releases fintech, com as auditorias de custo, a visão de custo por serviço e as correções de estabilidade citadas acima.