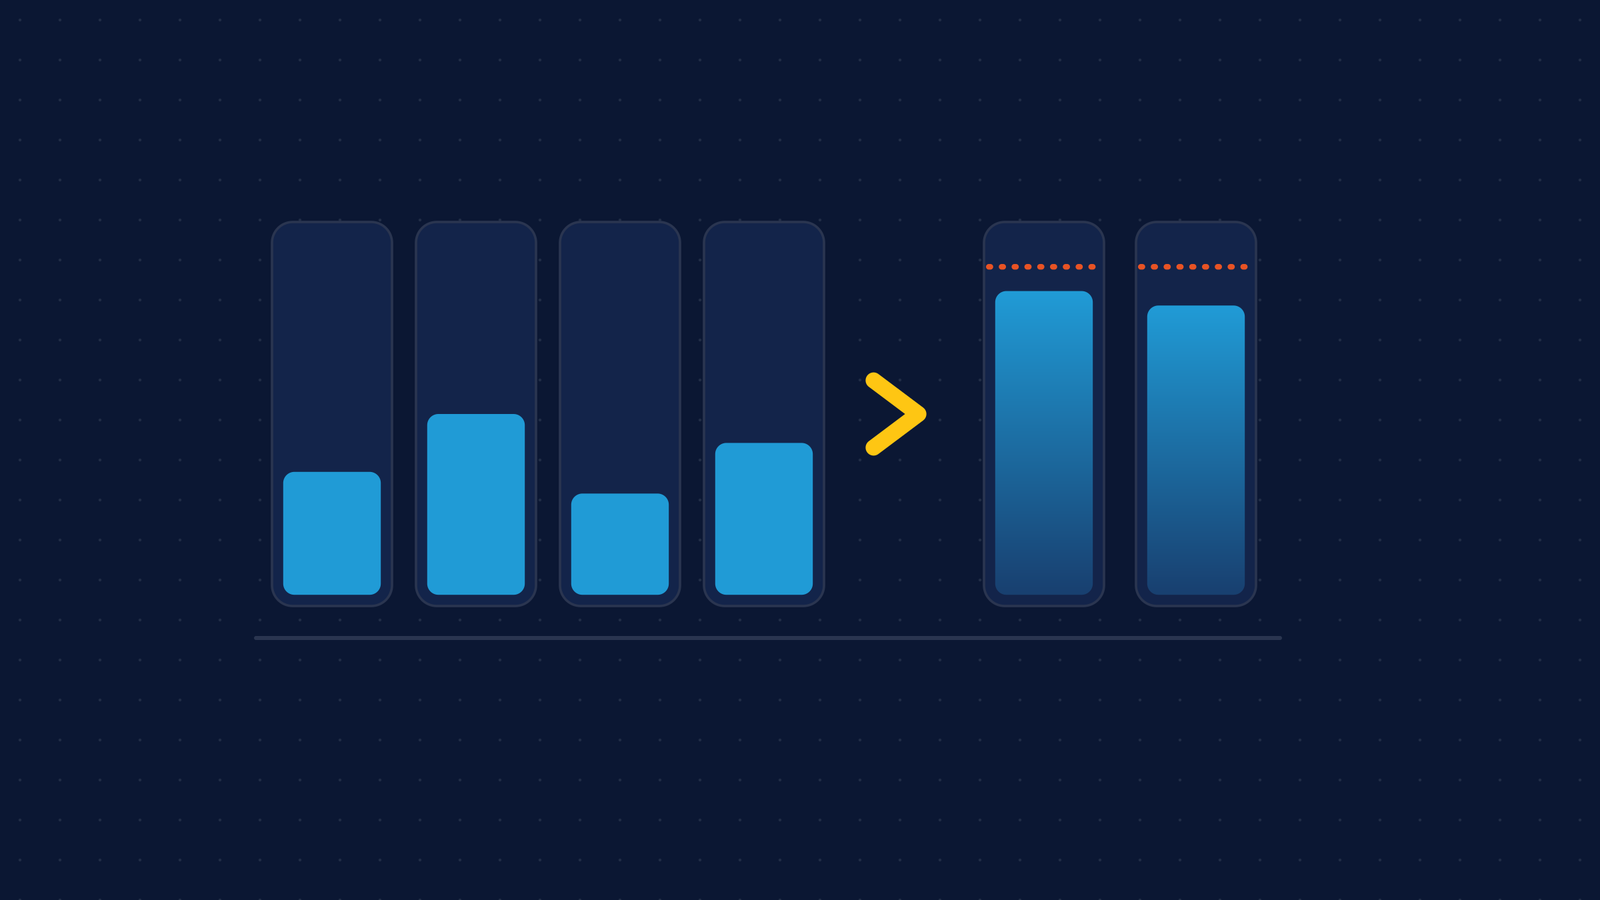
Empieza por la factura, no por el clúster. Dale a cada línea un dueño, un servicio o un equipo. Después compara lo que cada carga de trabajo solicita con su pico histórico, no con su promedio, porque lo que pagas son los requests. Y después decide cuánto puede trabajar la consolidación de nodos, porque ahorra moviendo tus pods. Ese es el orden que seguimos en las auditorías de costos de nube y de clústeres, entre ellas la de una plataforma SaaS fintech que uso más abajo.
Primero, un límite. El caso de ese proyecto menciona auditorías de costos y una vista de costo por servicio, y ninguna cifra de ahorro. Este artículo tampoco va a inventar una. Lo que el caso sí publica es el stack (AWS EKS con Karpenter), las auditorías y un conjunto de arreglos de estabilidad que están en la misma perilla que el costo. Vale la pena leerlos.
¿De quién es cada línea de la factura?
Antes de cambiar nada, atribuye cada línea a un servicio o a un equipo. Un costo sin dueño no se puede recortar con seguridad, porque no sabes qué depende de él. Si quieres que lo hagamos con tu propia cuenta, vendemos una Revisión de costos en la nube a precio fijo.
En esa plataforma fintech, el costo por servicio vive en el portal interno de desarrolladores, al lado del estado de despliegue del mismo servicio. Sus cifras vienen directamente de la API de facturación de la nube. Lo importante de ponerlo ahí no es el gráfico. Es que quien cambia un servicio ve lo que cuesta en el lugar donde ya está mirando.
Si no tienes un portal, haz lo mismo en una hoja de cálculo. Exporta la factura del mes pasado agrupada por servicio y por etiqueta, y cuenta las líneas sin dueño. Déjalas en una fila llamada “sin atribuir”, nunca redondeadas dentro de “otros”. Si esa fila es grande, deja de optimizar y arregla primero el etiquetado. Todo lo que sigue supone que sabes a quién preguntar. Para el marco general está qué es FinOps.
¿Cómo se dimensiona con picos históricos?
Por cómo programa Kubernetes. El scheduler ubica un pod según la suma de los requests de recursos en un nodo. La documentación de Kubernetes aclara que, aunque el uso real de un nodo sea muy bajo, el scheduler igual rechaza un pod cuyo request no cabe. Los requests deciden cuántos nodos corres, y los nodos son la factura.
Por eso la corrección que parece más barata, bajar los requests al promedio, es también la peligrosa. Los límites de memoria los aplica el kernel con kills por falta de memoria (OOM). La misma página dice que un contenedor que usa más que su límite de memoria puede ser terminado. El promedio es el número que termina en un pod eliminado. Dimensiona al máximo histórico, más un margen que elegiste a propósito.
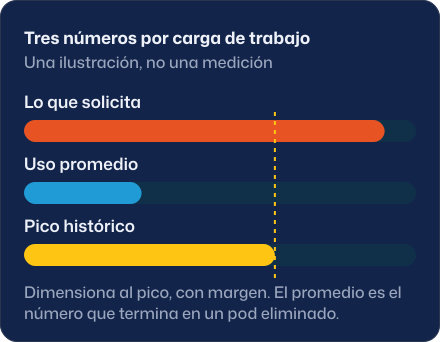
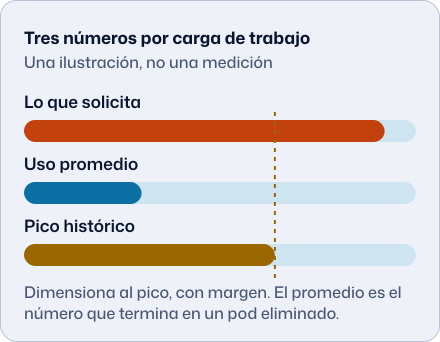
Dos detalles definen si funciona. La ventana tiene que incluir el peor evento que tengas: un reporte de fin de mes, el cierre de un trimestre, una promoción. Y se agrega por carga de trabajo, no por nombre de pod, porque los nombres cambian en cada despliegue y esconderían el historial. En Prometheus o un almacén compatible, con retención suficiente:
max by (namespace, container) (
  max_over_time(
    container_memory_working_set_bytes{container!=""}[90d]
  )
)
/
max by (namespace, container) (
  kube_pod_container_resource_requests{resource="memory"}
)
Un cociente muy por debajo de 1 es holgura que estás pagando. Uno cerca de 1 o mayor es una carga sin margen, cueste lo que cueste. Lee la lista desde arriba, revisa las más grandes con sus dueños y cambia una carga a la vez.
La forma de carga que más castiga esto es la que tiene picos. El caso fintech menciona una falla por falta de memoria en un reporte grande que se diagnosticó y se corrigió, y trabajos de reportes largos que ahora se drenan con gracia. No digo que esa falla fuera un error de dimensionamiento: la página no lo dice. Digo que las cargas de reportes son donde el promedio te miente.
¿Qué ahorra la consolidación de Karpenter y qué rompe?
La consolidación es Karpenter quitando nodos para bajar el costo. Su documentación enumera tres casos: un nodo está vacío, sus cargas caben en otros nodos o se puede reemplazar por una variante más barata. Por defecto un NodePool usa WhenEmptyOrUnderutilized con consolidateAfter: 0s, que la documentación presenta como la opción para quien quiere el menor costo posible y acepta la disrupción de pods que eso implica. WhenEmpty es el extremo conservador, y poner consolidateAfter en Never apaga la consolidación de ese NodePool.
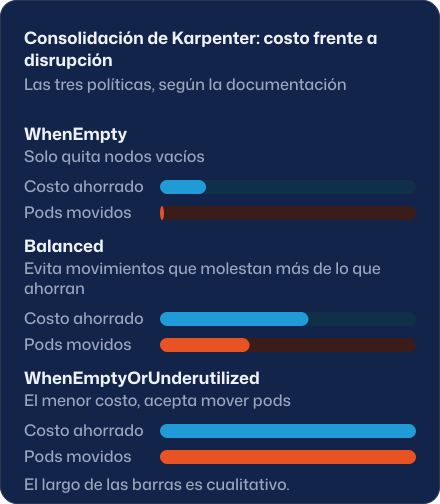
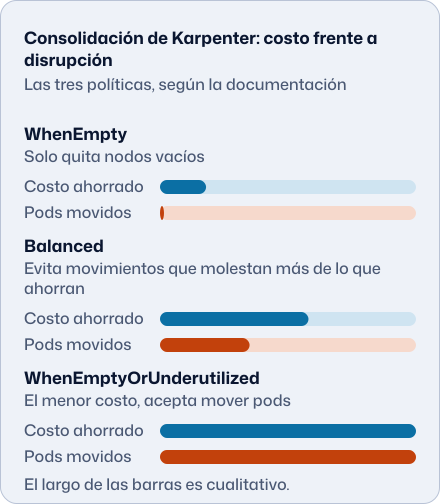
El ahorro y la disrupción salen del mismo mecanismo, así que no se consigue uno sin el otro. El caso fintech lista tres arreglos justo en esa perilla. La consolidación de nodos ya no recrea el almacén de logs unas tres veces al día. El autoescalado ya no elimina de golpe a la mayoría de los pods de reportes. Y los trabajos largos de reportes se drenan con gracia. La página no dice qué ajuste de Karpenter cambió, y no voy a adivinarlo.
Esto es lo que haría en cualquier clúster:
- Pon las cargas con estado y los trabajos largos en su propio NodePool, con una política conservadora.
- Marca con la anotación
karpenter.sh/do-not-disruptlos pods que no deben moverse. La documentación dice que puedes tratarla como un PodDisruptionBudget de un solo pod. - Define presupuestos de disrupción. Si no defines ninguno, Karpenter usa por defecto uno de 10 % de los nodos.
- Después de activar la consolidación, cuenta cuántas veces por día se recrea cada pod con estado. Ese número debería ser uno que elegiste, no uno que descubriste.
¿Qué no debes esperar?
Un porcentaje. No lo prometemos antes de leer tu factura, y un ahorro aparece en la factura o no es un ahorro, así que ahí lo medimos. Además las facturas se mueven con el uso, por eso comparar un solo mes antes y después prueba poco. Compara el costo por unidad de trabajo, como el costo por reporte o por cliente activo, en la misma ventana.
Las revisiones de costos forman parte de la consultoría cloud. Discovery cuesta USD 7,000 por 1 a 4 semanas cuando el destino sigue abierto. CI/CD e IaC cuesta USD 4,000 por 2 semanas cuando hay que construir o rehacer la infraestructura como código. Por hora, un Senior cuesta USD 45 a 50 y un Líder o Arquitecto, USD 55 a 60. La página de precios lo tiene todo, y tarifas de desarrolladores nearshore en 2026 explica cómo presupuestar horas.
Los artículos sobre Argo CD y Kargo y sobre Grafana vs Datadog cubren dos vecinos de este: cómo llegan las versiones al clúster y cuánto cuesta la observabilidad.
¿Qué puedes hacer en 30 minutos?
Elige tus tres cargas más grandes. Corre la consulta del pico para cada una, anota el cociente y el dueño, y exporta la factura del mes pasado agrupada por etiqueta. La cantidad de líneas sin dueño y los cocientes te dicen por dónde empezaría una auditoría.
Fuentes
- Karpenter, Disruption: políticas de consolidación,
consolidateAfter, presupuestos de disrupción por NodePool y la anotacióndo-not-disrupt. Consultado el 9 de octubre de 2026 (sha256 75da76dc…). - Kubernetes, Resource Management for Pods and Containers: programación por requests y límites de memoria aplicados con kills por OOM. Consultado el 9 de octubre de 2026 (sha256 8eee4a66…).
- Nuestro caso: pipeline de versiones fintech, con las auditorías de costos, la vista de costo por servicio y los arreglos de estabilidad citados arriba.